
从代码生成到长周期任务:通义千问的编程与智能体能力解析
开发者为什么要关注模型的“工程能力”
早期代码大模型主要比拼单函数补全,而今天开发者面对的是完整项目:跨文件理解、依赖配置、测试用例、文档撰写、报错定位和迭代修复。相应地,评价一个模型是否适合开发场景,也需要从“能不能写出一段函数”转向“能不能在工程流程里稳定配合”。通义千问这一代旗舰模型,正是围绕编程开发、前端设计和复杂智能体任务来定位的。
根据官方公开信息,Qwen4-Max在编程、智能体任务和视觉推理等方向表现突出,在真实编程榜单Code Arena上排在第6位;模型支持联网搜索、工具调用和结构化输出,并兼容OpenAI与Anthropic API,降低了已有工程的迁移成本。
代码生成与项目级理解
在代码生成层面,模型可以根据自然语言需求产出完整项目的结构设计、多份代码文件、依赖配置清单、测试用例和说明文档。对于已有项目,则可以用于仓库级代码理解:解析源码结构、识别冗余逻辑和潜在Bug、完成跨文件重构建议。这类能力在熟悉遗留系统、梳理陌生代码库、生成注释和接口说明时比较实用。
需要提醒的是,模型生成的代码必须经过本地运行、代码审查和安全测试。涉及权限、加密、支付、数据处理等敏感逻辑时,不能直接复制上线,尤其要检查注入风险、越权访问和敏感信息泄露等常见问题。
调试诊断与错误定位
调试是开发中耗时较多的环节。把报错日志、相关代码片段和复现步骤提供给模型,它可以帮助定位故障根源、分析可能原因,并给出修复方案。相比泛泛地问“报错怎么办”,上下文越完整——包括语言框架版本、调用栈、预期行为和实际结果——诊断越有针对性。
即便如此,模型给出的修复建议仍需验证:有些修改可能只解决表层报错,却引入新的边界问题。建立“模型给方案、人来判断和验证”的配合方式,比盲目采纳建议更稳妥。
工具调用与长周期自主任务
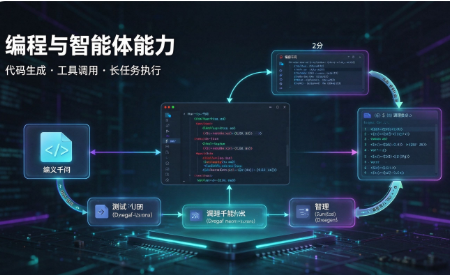
智能体能力是这一代模型的重点方向。模型可以自主拆解目标、规划执行步骤、调用外部工具、根据反馈迭代纠错,闭环完成多步骤任务。官方资料显示,通义千问系列在此前版本中就展示过长周期自主运行能力,能够在较长时间内连续完成代码生成、测试、预览和日志分析的迭代闭环。Qwen4-Max进一步强化了长周期任务执行和最终交付质量。
在工程落地中,工具调用通常配合API、函数调用规范和外部系统权限使用。团队需要设计好工具边界、输入输出校验和异常回滚机制,避免智能体在缺少约束的情况下产生不可控操作。长任务场景下,中间结果留存和人工介入节点同样不可缺少。
接入方式与选型建议
开发者可以通过QwenCloud的API接入Qwen4-Max,也可以在Qwen Studio、QwenWork和Qoder等渠道体验模型能力。API兼容OpenAI与Anthropic格式,便于在现有客户端和框架中替换调用。官方还表示后续将推出规模更小的Qwen4系列模型并公开权重,这意味着团队除了调用云端API,未来也有机会基于开源权重做私有化部署和定制化微调。
选型时建议按任务分层:高频、简单、对成本敏感的场景使用轻量模型;复杂项目重构、长周期智能体和高难度调试再使用旗舰模型。先用小规模真实任务做评测,记录代码可运行率、修复准确率、Token消耗和单次任务成本,再决定是否扩大使用范围,比直接凭榜单排序更可靠。


- 2026-11-16
- 2026-11-16
- 2026-11-16
- 2026-11-16
