
2026年想用国产大模型,通义千问处于什么位置?选型思路梳理
选型先从自身需求出发
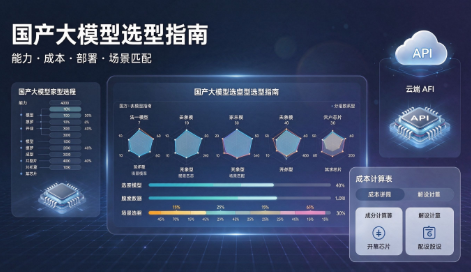
大模型没有绝对的“最好”,只有是否匹配具体任务。选型前先回答三个问题:使用者是谁——个人用户、开发者还是企业团队;主要做什么——日常问答与写作、代码开发、长文档处理、多模态分析还是业务系统接入;约束条件是什么——预算、数据敏感度、部署方式、响应速度和合规要求。需求不同,看重的指标顺序也完全不同。
通义千问的基本定位
通义千问是阿里巴巴推出的大模型系列,覆盖从云端旗舰模型到开源权重模型的不同层级。2026年8月发布的Qwen3.8-Max为2.4万亿参数规模、支持百万Token上下文的多模态旗舰;2026年11月16日发布的Qwen4-Max继续沿MoE路线升级,原生支持视觉理解,上下文窗口为100万Token,面向办公、创意、开发和科研等复杂任务。除旗舰版本外,Qwen系列也提供中小规模模型,并陆续公开权重,供开发者部署和二次开发。
对用户来说,这意味着同一个系列内部就有不同档位可选:日常轻量使用走线上对话入口,复杂业务通过API接入旗舰模型,有私有化需求则关注后续开源版本。
几个关键选型维度
上下文长度。需要一次性读入长文档、整份代码仓库或大量对话记录时,上下文窗口是硬指标。通义千问旗舰版本支持百万Token级别上下文,适合长资料分析和长程任务;但上下文越长,调用成本和响应耗时也会变化,需要结合实际任务权衡。
多模态能力。如果业务需要理解图片、截图、户型图、视频素材等非文本输入,就要考察模型的视觉理解能力。Qwen4-Max原生支持视觉理解,适合图文联动分析类场景;纯文本为主的业务则不必为用不到的模态付费。
编程与智能体能力。开发者选型重点看代码可运行率、项目理解、工具调用稳定性和长任务表现。可以结合真实项目做小规模评测,而不是只看公开榜单排名。
开源与部署方式。对数据敏感、需要内网部署或定制微调的团队,模型权重是否开放、社区生态是否成熟十分关键。Qwen系列承诺后续放出小规模开源模型,具体型号和时间以官方公告为准。
接入方式与成本。云端API接入快、运维成本低;私有化部署可控性强但投入更高。成本方面要综合看输入输出价格、缓存命中价格、Token消耗量和单次任务费用,旗舰模型与轻量模型搭配使用通常更经济。
不同用户的选型建议
个人用户优先考虑使用体验、对话流畅度和是否覆盖日常写作、翻译、问答需求,多数场景通过官方线上入口即可满足,不必纠结参数规模。开发者建议从API文档、模型档位、协议兼容和开源路线入手,先用测试任务验证代码与工具调用能力,再接入正式应用。企业团队则应围绕数据合规、流程嵌入、评估指标和总体成本做规划,必要时采用云端API与私有化部署组合的分层方案。
理性看待对比与榜单
各类榜单能反映模型在标准化测试中的相对水平,但真实业务表现还取决于数据质量、提示方式、工具配套和流程设计。横向对比时,建议用同一批自己业务中的真实样本测试多个候选模型,记录完成质量、错误类型、响应速度和费用,再做决策。
总体而言,通义千问在2026年的国产大模型格局中,属于覆盖旗舰云端模型与开源生态、能力偏向复杂工作任务的完整系列。是否适合自己,最终要回到具体场景:任务是否匹配、成本是否可接受、数据是否合规、团队能否完成评估与运维。把这些问题想清楚,选型就不容易被单一宣传点带偏。


- 2026-11-16
- 2026-11-16
- 2026-11-16
- 2026-11-16
